Typecho 蜘蛛日志插件 SpiderLog
本文更新于 4 小时前
SpiderLog 把每一次蜘蛛来访记进数据库,在后台列出来:谁来的、抓了哪个页面、从哪个 IP、什么时候。
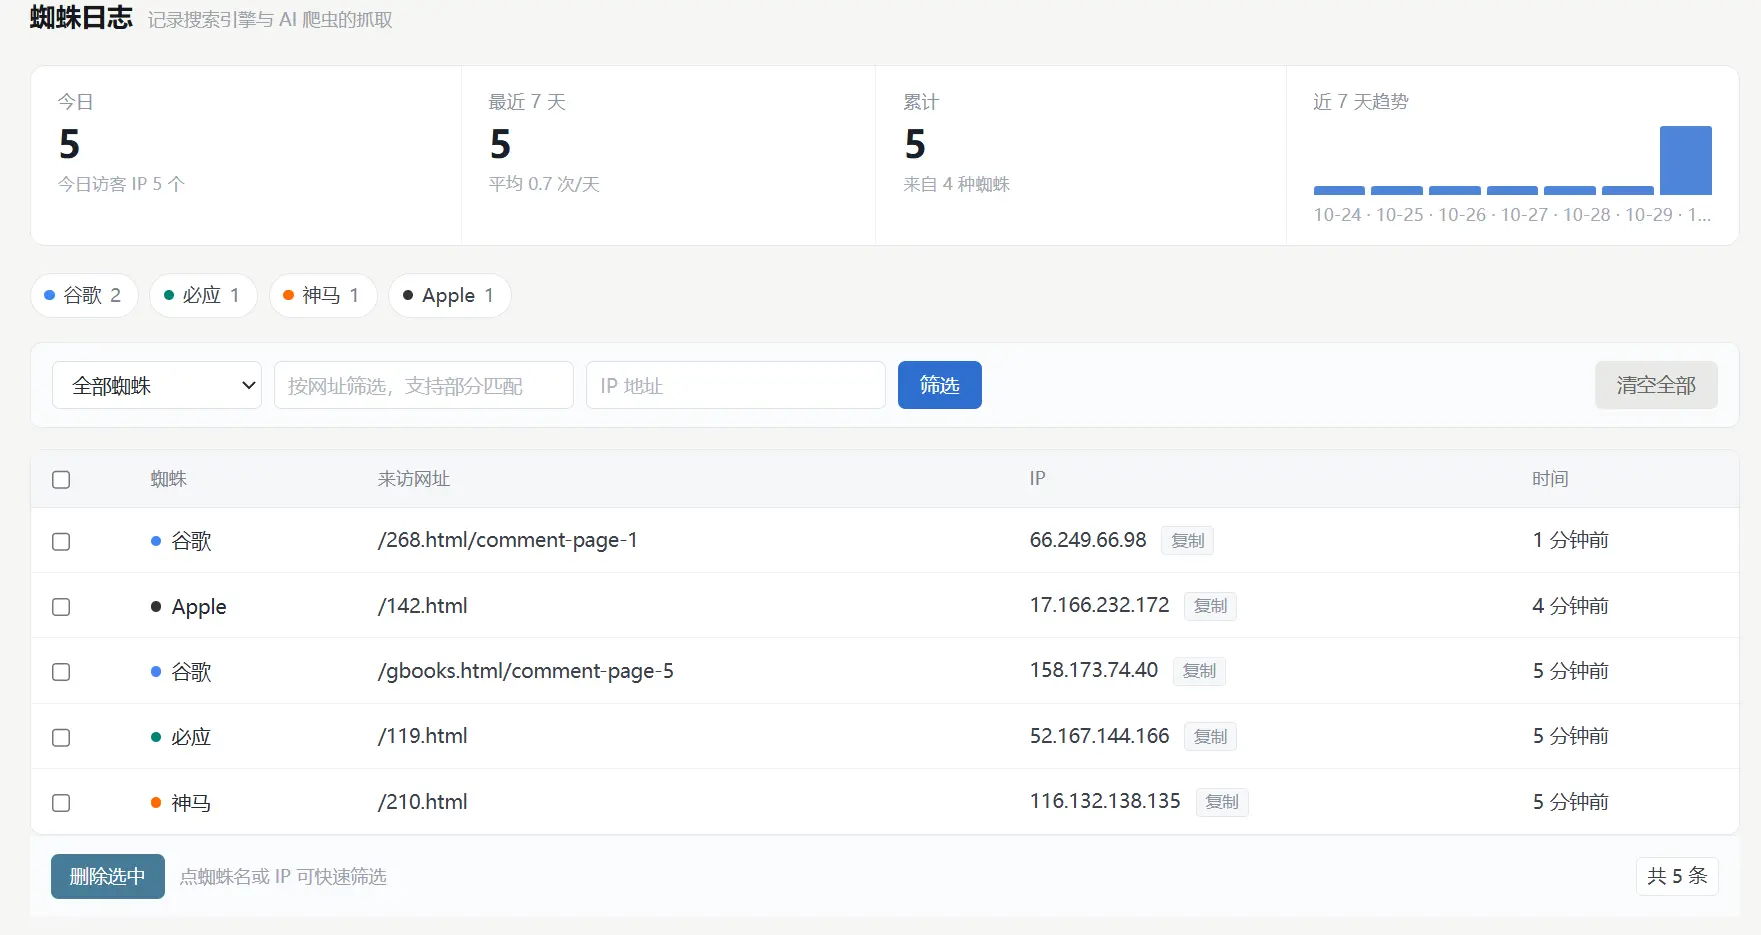
它记录什么
| 字段 | 例子 |
|---|---|
| 蜘蛛 | 百度、谷歌、GPTBot、Claude、头条、搜狗 |
| 来访地址 | /archives/10.html |
| IP | 220.181.108.88 |
| 时间 | 54 分钟前 |
识别靠 User-Agent 里的关键词,内置 35 条规则,分三类:
- 搜索引擎:百度、谷歌、必应、搜狗、360、头条、Yandex、DuckDuckGo
- AI 抓取器:GPTBot、ChatGPT-User、ClaudeBot、Claude-Web、PerplexityBot、CCBot、AmazonBot、AppleBot
- 订阅与社交预览:Feedly、Inoreader、Telegram、Twitter、Facebook
规则表在后台可以自己改,一行一个 关键词=显示名。
安装
- 把
SpiderLog整个目录上传到usr/plugins/ - 后台「控制台 → 插件」,找到 SpiderLog,点启用
- 「控制台」菜单下会出现蜘蛛日志入口
启用时自动建表 typecho_spider_log,不需要导入 SQL。
日志一开始是空的,这是正常的。浏览器不是蜘蛛,你自己访问不会产生记录。
筛选
筛选条有三项:
- 蜘蛛下拉:选一个具体蜘蛛
- 网址:模糊匹配,比如填
archives只看归档页 - IP:精确查某个 IP
操作
- 每行前面的勾选框可以多选,底部「删除选中」一次性删掉
- IP 后面的「复制」按钮,点一下就复制到剪贴板
- 右上角「清空全部」,清空所有记录
配置项
| 项 | 默认 | 说明 |
|---|---|---|
| 蜘蛛识别表 | 35 条 | 长词要写在短词前面,baiduspider 得排在 spider 之前 |
| AI 爬虫是否入库 | 一起记录 | 只想看搜索引擎就选「只记搜索引擎」 |
| 同一页面去重窗口 | 60 秒 | 同一 IP 抓同一地址,这个时间内只记一次,填 0 关闭 |
| 已登录用户访问时 | 跳过 | 自己访问前台不记录 |
| 日志每页条数 | 20 | |
| 日志保留天数 | 90 | 每次打开日志页顺手清掉超期的,填 0 永久保留 |
| 停用插件时 | 保留数据 | 也可以选连表一起删掉 |
怎么确认它在工作
等蜘蛛自己来可能要几小时。想立刻看到效果,用命令模拟一次:
curl -A "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" \
     https://你的域名/
刷新日志页,会出现一条「百度」记录。
把 UA 换成 GPTBot 的关键词,就能验证 AI 爬虫这条链路也通。
兼容性
- Typecho 1.3.x
- Typecho 1.2 也可以
- PHP 7.4 / 8.x
- 不依赖第三方服务,不发起外部请求
下载
有问题在评论区说。
(野) 网文备字 (2026) 第 96795 号
刚好在找这方面的教程,博主辛苦。